Maßgeschneiderte LLM-Integration für moderne Unternehmensanwendungen
Wir integrieren modernste Large Language Models (LLMs) wie OpenAI GPT-4o, Anthropic Claude und Open-Source-Modelle via RAG-Architekturen sicher in Ihre bestehenden Systeme. Steigern Sie Effizienz und Wissenszugriff – ohne Ihre Datenhoheit zu gefährden.
Typische Hürden, die wir mit LLM-Integration lösen
Ohne maßgeschneiderte Lösungen stoßen Standard-Tools und manuelle Prozesse schnell an ihre Grenzen.
Datenschutz & DSGVO-Risiken
Unternehmen befürchten zu Recht, dass vertrauliche Kundendaten oder Geschäftsgeheimnisse zum Training öffentlicher Modelle genutzt werden.
Halluzinationen & ungenaue Antworten
Standard-Chatbots erfinden Fakten, wenn ihnen die direkte semantische Anbindung an firmeneigene Dokumente und Datenbanken fehlt.
Hohe API-Kosten & Latenzen
Unoptimierte Prompt-Ketten und fehlende Caching-Strategien treiben Token-Kosten in die Höhe und verlangsamen Antworten für Nutzer.
Mangelnde Schnittstellenanbindung
KI isoliert als reiner Chatbot bringt wenig Nutzen, wenn sie keine internen ERP-, CRM- oder Ticketing-Aktionen eigenständig ausführen kann.
Unsere Enterprise LLM & RAG-Lösungsarchitektur
Wir entwickeln maßgeschneiderte, sichere KI-Pipelines mit Zero-Data-Retention-Garantie, semantischer Vektorsuche und Tool-Calling.
Leistungsmerkmale & Module im Detail
Jede Komponente wird passgenau auf Ihre Geschäftsanforderungen abgestimmt und kontinuierlich gepflegt.
RAG Wissensdatenbank (Retrieval-Augmented Generation)
Echtzeit-Indexierung Ihrer Handbücher, Verträge, Notizen und PDFs mit semantischen Embeddings für präzise Zitate.
Multi-Model Orchestrierung
Dynamisches Routing zwischen GPT-4o, Claude 3.5 Sonnet und schnellen Micro-Modellen für das optimale Kosten-Leistungs-Verhältnis.
Datenschutzfilter & PII-Redaktion
Automatisches Maskieren von Namen, IBANs, Telefonnummern und Passwörtern vor dem Senden an das Sprachmodell.
Semantisches Caching
Wiederkehrende Anfragen werden im Redis-Vektorspeicher zwischengespeichert – für Antwortzeiten unter 100ms.
Function Calling & API Connectors
Das LLM liest nicht nur, sondern erstellt Tickets, generiert PDFs oder bucht Termine in Ihren Fachanwendungen.
Evaluations- & Monitoring-Dashboard
Laufendes Tracking von Token-Verbrauch, Antwortqualität, Latenzzeiten und Nutzerfeedback via Langfuse / Helicone.
Wie Ihr Unternehmen messbar profitiert
Klare Resultate: Mehr Effizienz, geringere Betriebskosten und zufriedenere Kunden.
80% schnellere Recherche
Mitarbeiter finden komplexe Fachinformationen in Tausenden internen Dokumenten in Sekunden statt Stunden.
100% DSGVO-Sicherheit
Garantiert kein Modelltraining mit Ihren Eingaben; Hosting in nach ISO 27001 zertifizierten EU-Rechenzentren.
60% geringere Betriebskosten
Intelligentes Modell-Routing und Vektor-Caching minimieren teure Token-Abrechnungen spürbar.
Zukunftssichere Unabhängigkeit
Modulare Architektur ohne Vendor-Lock-in – wechseln Sie jederzeit mit einem Klick zwischen OpenAI, Anthropic oder Open-Source.
Vom Erstgespräch bis zum Produktivstart
Unser 5-Phasen-Modell garantiert transparente Meilensteine, pünktliche Umsetzung und verlässliche Budgets.
Use-Case & Daten-Audit
Analyse Ihrer Dokumentenstruktur, Sicherheitsanforderungen und Definition konkreter KPI-Ziele.
Vektor-Pipeline & Ingestion
Extraktion, Chunking und semantische Vektorisierung Ihrer Wissensdaten in Vektor-Datenbanken.
Prompt Engineering & Tool Calling
Optimierung von System-Prompts, Few-Shot-Beispielen und Implementierung von API-Funktionsaufrufen.
UI-Integration & Guardrails
Entwicklung von modernen Benutzeroberflächen oder Integration in Slack, Teams und bestehende Web-Apps.
Rollout & Observability
Staging-Tests, Lastprüfungen, Mitarbeiter-Schulung und Aktivierung von Monitoring-Dashboards.
Für welche Branchen sich dieser Service besonders lohnt
Maßgeschneidert auf reale Einsatzszenarien für maximale Wirkung.
Intelligente Vertragsanalyse & Aktenrecherche
Automatisches Durchsuchen von Hunderten Verträgen nach Klauseln, Risiken und Fristen mit sekundenschneller Zusammenfassung.
Digitaler Service-Copilot für Techniker
Techniker befragen unterwegs Schaltpläne und Wartungsbücher per Sprache oder Text und erhalten präzise Handlungsanweisungen.
Autonomer 24/7 Kundenberater mit Shop-Anbindung
KI beantwortet Detailfragen zu Produktspezifikationen, prüft Lagerbestände live und leitet Bestellungen ein.
Realisierte Kundenprojekte
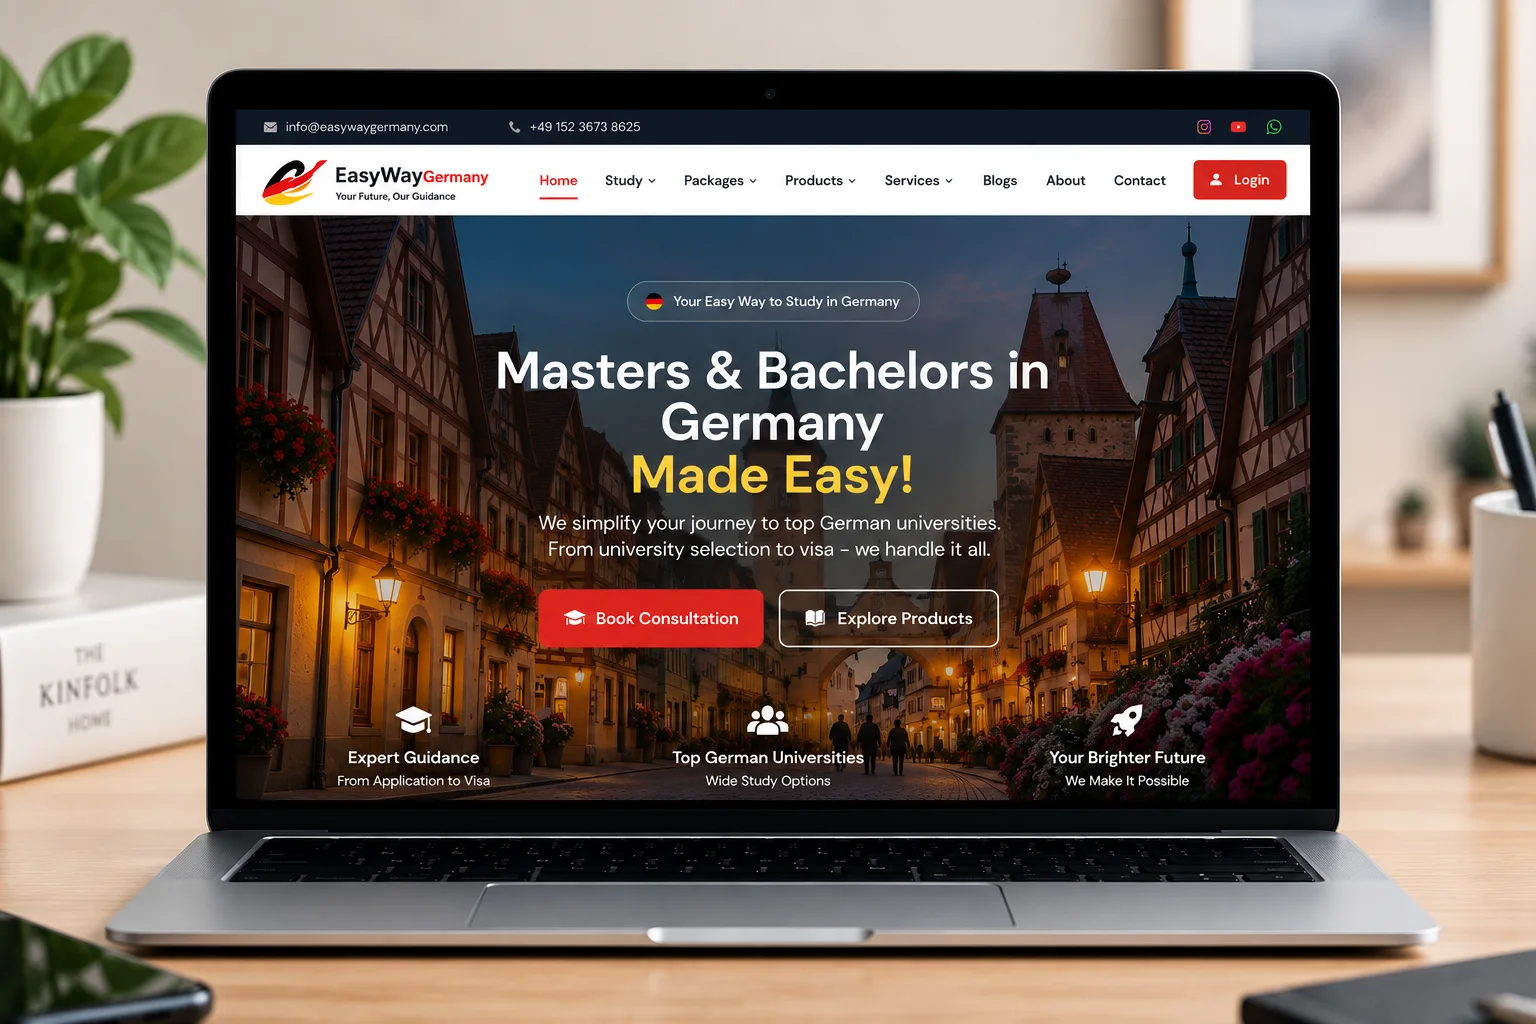
Eine Bildungsberatung für Studieninteressierte in Deutschland mit geführtem Zulassungsprozess.
Weiterführende Artikel zu diesem Thema
Fragen & Antworten zu LLM-Integration
Hier finden Sie transparente Antworten auf die wichtigsten Fragen rund um Ablauf, Technik und Budget.
Bereit für Ihr Projekt im Bereich LLM-Integration?
Sprechen Sie direkt mit unseren Entwicklern und Lösungsarchitekten. Wir analysieren Ihre Anforderungen und erstellen innerhalb von 24 Stunden einen verbindlichen Festpreis-Kostenvoranschlag und Zeitplan.